
22
0
0
1、Hadoop基础环境安装
1、Hadoop组成
1.1 Hadoop各个版本的区别

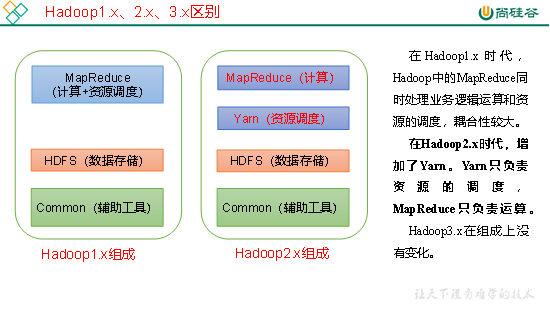
在Haddoop 1.x的时期,是需要开发手动处理资源调度的
在Hadoop 2.x的时期,加入了yarn组件,由yarn来负责资源的调度,开发则只需要做好代码做计算。
在Hadoop 3.x的时期,在组成上没有变化
1.2 HDFS架构概述
# 简介
Hadoop Distributed File System,简称HDFS,是一个分布式文件系统

# 组件
`NmaeNode`(nn)(主节点):存储文件的元数据,如文件名、文件目录结构、文件属性(生成时间、副本数、文件权限),以及每个文件的块列表和块所在的DataNode等。
`DataNode`(dn)(数据节点):在本地文件系统存储文件块数据,以及块数据的校验和。
`Secondary NameNode`(辅助名称节点):每隔一段时间对NameNode元数据备份	# 从NameNode获取文件系统的元数据和编辑日志,然后将它们合并,生成一个新的文件系统映像,从而减少NameNode的启动时间和内存消耗
1.3 YARN架构概述

# 简介
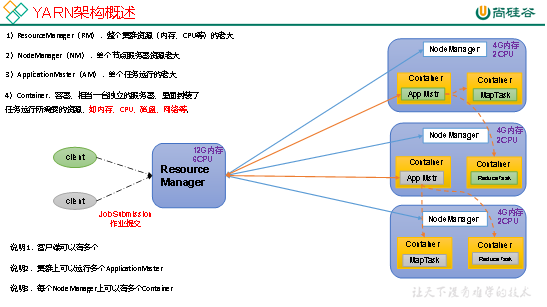
YARN(Yet Another Resource Negotiator)是 Hadoop 2.x 版本引入的一种资源管理和作业调度框架,用于替代原有的 Hadoop 1.x 的 MapReduce 作为资源管理和作业调度的唯一机制。YARN 提供了更高效的资源管理和更灵活的作业调度能力

# 组件
`ResourceManager`(RM):
    RM是YARN中的核心组件,负责整个集群资源的管理和作业调度。
    `Scheduler`(调度器):是YARN的组件之一,负责资源的调度,按照预定的策略(如公平调度器或容量调度器)分配资源给各个运行在集群上的应用程序。
    `ApplicationManager`(应用程序管理器):是YARN的组件之一,负责处理客户端的作业提交请求,管理作业的生命周期以及监控作业的执行

`NodeManager`(NM):
    NM是 YARN 中运行在每个节点上的组件,负责管理单个节点上的计算资源。
    NM监听其所在节点的资源使用情况(CPU、内存等),并像RM报告。
    NodeManager 也负责管理`Container`(容器),容器是 YARN 分配给应用程序的资源的抽象(包括 CPU、内存等)。
    NM处理来自RM的命令,启动或停止容器内的任务。

`ApplicationMaster`(AM):
    AM负责管理作业的生命周期,包括作业的提交、监控和终止。

# 个人小结:
    RM负责整个集群资源的管理和作业调度,但是RM不直接管理NM,NM是负责单个节点的资源计算,RM通过NM通信获取该节点的资源使用情况,并向其分发资源。
    当一个任务需要资源时,资源的计算和分配都是RM来进行分配的,即当一个任务的AM向RM申请发送资源请求,RM会通过NM反馈的信息,计算给该任务的资源需求,并把该请求发给NM,NM收到请求后会启动容器,该容器的资源就是给该任务的。
1.4 MapReduce简单介绍
MapReduce将计算过程分为两个阶段:Map和Reduce。
(1)Map阶段并行处理输入数据
(2)Reduce阶段对Map结果进行汇总
2、Hadoop安装
2.1 安装Centos7基础环境
1、按步骤安装Centos7虚机环境
2、永久关闭防火墙
    systemctl stop firewalld
    systemctl disable firewalld
3、配置网卡
vi /etc/sysconfig/network-script/ifcfg-ens33	# 需要配置静态ip,ip地址自己定义
BOOTROTO="static"
IPADDR="自定义IP"
GATEWAY="网关IP"
DNS1="DNS服务器IP"

然后重启网卡 systemctl restart network

4、配置yum源、epel源(此处使用阿里云的)(可选项)
# yum源
mv /etc/yum.repos.d/CentOS-Base.repo /etc/yum.repos.d/CentOS-Base.repo.backup
curl -o /etc/yum.repos.d/CentOS-Base.repo https://mirrors.aliyun.com/repo/Centos-7.repo
yum makecache
yum install vim wget curl net-tools tree lsof unzip zip psmisc  nc  rsync  lrzsz  ntp libzstd openssl-static tree iotop git -y	# 常用工具

# epel源
mv /etc/yum.repos.d/epel.repo /etc/yum.repos.d/epel.repo.backup
mv /etc/yum.repos.d/epel-testing.repo /etc/yum.repos.d/epel-testing.repo.backup
wget -O /etc/yum.repos.d/epel.repo https://mirrors.aliyun.com/repo/epel-7.repo

5、更改主机名
vim /etc/hostname
hadoop101

6、创建账户
useradd mhm
passwd mhm	# 密码为1

7、提示mhm用户权限
vim /etc/sudoers
mhm     ALL=(ALL)       NOPASSWD:ALL

8、创建目录
mkdir /opt/software  # 软件包存储位置
mkdir /opt/module  # 软件包解压目录
chown mhm:mhm /opt/software
chown mhm:mhm /opt/module

9、更改hosts文件(windows的也可以改下)
vim /etc/hosts
192.168.146.101 hadoop101
192.168.146.102 hadoop102
192.168.146.103 hadoop103
192.168.146.104 hadoop104

10、通过hadoop101克隆3台机器
克隆完再都修改一下ip和主机名
2.2 安装Hadoop单机环境
1、上传jar包至102服务器/opt/software/
hadoop-3.1.3.tar.gz
jdk-8u212-linux-x64.tar.gz

2、解压缩jdk
tar -xzvf /opt/software/jdk-8u212-linux-x64.tar.gz -C /opt/module/

3、添加环境变量
vim /etc/profile.d/my_env.sh
# JAVA_HOME
export JAVA_HOME=/opt/module/jdk1.8.0_212
export PATH=$PATH:$JAVA_HOME/bin
# 刷新配置
source /etc/profile
# 查看是否生效
[root@hadoop102 bin]# java -version
java version "1.8.0_212"
Java(TM) SE Runtime Environment (build 1.8.0_212-b10)
Java HotSpot(TM) 64-Bit Server VM (build 25.212-b10, mixed mode)

4、解压缩hadoop的jar包
tar -xzvf /opt/software/hadoop-3.1.3.tar.gz -C /opt/module/

5、配置环境变量
vim /etc/profile.d/my_env.sh
# HADOOP_HOME
export HADOOP_HOME=/opt/module/hadoop-3.1.3
export PATH=$PATH:$HADOOP_HOME/bin
export PATH=$PATH:$HADOOP_HOME/sbin
# 刷新配置
source /etc/profile
# 查看是否生效
[root@hadoop102 bin]# hadoop version
Hadoop 3.1.3
Source code repository https://gitbox.apache.org/repos/asf/hadoop.git -r ba631c436b806728f8ec2f54ab1e289526c90579
Compiled by ztang on 2019-09-12T02:47Z
Compiled with protoc 2.5.0
From source with checksum ec785077c385118ac91aadde5ec9799
This command was run using /opt/module/hadoop-3.1.3/share/hadoop/common/hadoop-common-3.1.3.jar

#################################### 测试服务案例 ####################################
cd /opt/module/hadoop-3.1.3
# 创建测试目录
mkdir input
# 创建文件
vim word.txt
hadoop yarn
hadoop mapreduce
mhm
mhm

# 执行jar包
hadoop jar $HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.1.3.jar wordcount input output

# 查看输出文件
[root@hadoop102 hadoop-3.1.3]# ll output/
总用量 4
-rw-r--r--. 1 root root 45 5月  28 01:22 part-r-00000
-rw-r--r--. 1 root root  0 5月  28 01:22 _SUCCESS
[root@hadoop102 hadoop-3.1.3]# cd output/
[root@hadoop102 output]# cat part-r-00000
hadoop	2
mapreduce	1
mhm	2
yarn	1
2.3 Hadoop的目录介绍
[root@hadoop102 hadoop-3.1.3]# ll
总用量 176
drwxr-xr-x. 2 mhm mhm    183 9月  12 2019 bin
drwxr-xr-x. 3 mhm mhm     20 9月  12 2019 etc
drwxr-xr-x. 2 mhm mhm    106 9月  12 2019 include
drwxr-xr-x. 3 mhm mhm     20 9月  12 2019 lib
drwxr-xr-x. 4 mhm mhm    288 9月  12 2019 libexec
-rw-rw-r--. 1 mhm mhm 147145 9月   4 2019 LICENSE.txt
-rw-rw-r--. 1 mhm mhm  21867 9月   4 2019 NOTICE.txt
-rw-rw-r--. 1 mhm mhm   1366 9月   4 2019 README.txt
drwxr-xr-x. 3 mhm mhm   4096 9月  12 2019 sbin
drwxr-xr-x. 4 mhm mhm     31 9月  12 2019 share

2)重要目录
(1)bin目录:存放对Hadoop相关服务(hdfs,yarn,mapred)进行操作的脚本
(2)etc目录:Hadoop的配置文件目录,存放Hadoop的配置文件
(3)lib目录:存放Hadoop的本地库(对数据进行压缩解压缩功能)
(4)sbin目录:存放启动或停止Hadoop相关服务的脚本
(5)share目录:存放Hadoop的依赖jar包、文档、和官方案例
2.4 配置分布式Hadoop集群
2.4.1 服务器准备工作
# 如上,已经配置好了102服务器单节点Hadoop
1、在102节点上,分发软件包给103和104节点	# 发送之前可以删除hadoop家目录下的/share/doc ,此目录下是帮助文档,数量多,影响传输IO
scp -r /opt/module/hadoop-3.1.3/ mhm@192.168.146.103:/opt/module/  # 分发103的hadoop软件
scp -r /opt/module/hadoop-3.1.3/ mhm@192.168.146.104:/opt/module/  # 分发104的hadoop软件
scp -r /opt/module/jdk1.8.0_212/ mhm@192.168.146.103:/opt/module/  # 分发103的jdk软件
scp -r /opt/module/jdk1.8.0_212/ mhm@192.168.146.104:/opt/module/  # 分发104的jdk软件

2、修改103和104的环境变量
scp /etc/profile.d/my_env.sh root@192.168.146.103:/etc/profile.d/
scp /etc/profile.d/my_env.sh root@192.168.146.104:/etc/profile.d/
# 或者以下直接复制
cat > /etc/profile.d/my_env.sh << 'EOF'
# JAVA_HOME
export JAVA_HOME=/opt/module/jdk1.8.0_212
export PATH=$PATH:$JAVA_HOME/bin
# HADOOP_HOME
export HADOOP_HOME=/opt/module/hadoop-3.1.3
export PATH=$PATH:$HADOOP_HOME/bin
export PATH=$PATH:$HADOOP_HOME/sbin
EOF

3、刷新环境变量
source /etc/profile

4、检查环境变量
[root@hadoop104 module]# java -version
[root@hadoop104 module]# hadoop version

5、rsync(了解)	# 注意,使用的双方节点都需要下载rsync
# 102节点,将102节点的对应目录下的所有文件,复制到对方指定目录,但是不会复制对方已有的文件。
rsync -av /opt/module/* hadoop103:/opt/module/
    -a:递归方式同步文件和目录,并保持所有文件属性,包括权限、时间戳等
    -v:表示在执行同步时显示详细输出,以便查看同步的进度和结果。


6、下载ansible工具
yum -y install ansible
ansible --version	# 查看版本
cat > /etc/ansible/hosts << EOF
192.168.146.102 hadoop102
192.168.146.103 hadoop103
192.168.146.104 hadoop104
EOF

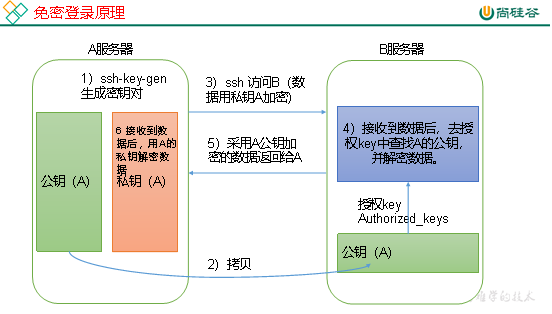
7、配置同集群内节点免密登录
# 全部节点都做,用户用mhm和root用户
ssh-keygen -t rsa	# 生成公钥和私钥,后续一直按回车
ssh-copy-id hadoop102
ssh-copy-id hadoop103
ssh-copy-id hadoop104
- 免密登录原理

2.4.2 集群规划与配置文件说明
- 集群规划
1、NameNode和SecondaryNameNode不要安装在同一台服务器(提高高可用性,SN可以备份元数据)
2、ResourceManager也很消耗内存,不要和NameNode、SecondaryNameNode配置在同一台机器上。
| 主机 | HDFS | YARN |
|---|---|---|
| hadoop102 | NameNode DataNode | NodeManager |
| hadoop103 | DataNode | ResourceManager NodeManager |
| hadoop104 | SecondaryNameNode DataNoda | NodeManager |
- 配置文件说明
Hadoop配置文件分两类:`默认配置文件`和`自定义配置文件`,只有用户想修改某一默认配置值时,才需要修改自定义配置文件,更改相应属性值。
| 要获取的默认文件 | 文件存放在Hadoop的jar包中的位置 |
|---|---|
| [core-default.xml] | hadoop-common-3.1.3.jar/core-default.xml |
| [hdfs-default.xml] | hadoop-hdfs-3.1.3.jar/hdfs-default.xml |
| [yarn-default.xml] | hadoop-yarn-common-3.1.3.jar/yarn-default.xml |
| [mapred-default.xml] | hadoop-mapreduce-client-core-3.1.3.jar/mapred-default.xml |
| 目录 | 核心配置文件(用户可以根据项目需求重新进行修改配置) |
|---|---|
| /opt/module/hadoop-3.1.3/etc/hadoop | core-site.xml、hdfs-site.xml、yarn-site.xml、mapred-site.xml |
- 默认配置文件
- 自定义配置文件
2.4.3 集群端口
| daemon | APP | 端口 |
|---|---|---|
| NameNode | NameNode | 9820 |
| NameNode | NameNode UI | 9870 |
| SecondaryNameNode | SecondaryNameNode | 9869 |
| SecondaryNameNode | SecondaryNameNode UI | 9868 |
| DataNode | DataNode IPC(同rpc,即服务干活的端口) | 9876 |
| DataNode | DataNode | 9866 |
| DataNode | DataNode UI | 9864 |
| History | 通信端口 | 19888 |
| mapreduce查看执行任务端口 | 8088 |
2.4.4 编辑配置文件并分发
- 102节点 /opt/module/hadoop-3.1.3/etc/hadoop/core-site.xml
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>

<configuration>
    <!-- 指定NameNode的地址 -->
    <property>
        <name>fs.defaultFS</name>

        <value>hdfs://hadoop102:8020</value>

    </property>

    <!-- 指定hadoop数据的存储目录 -->
    <property>
        <name>hadoop.tmp.dir</name>

        <value>/opt/module/hadoop-3.1.3/data</value>

    </property>

    <!-- 配置HDFS网页登录使用的静态用户为mhm -->
    <property>
        <name>hadoop.http.staticuser.user</name>

        <value>mhm</value>

    </property>

</configuration>
- hdfs-site.xml
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>

<configuration>
    <!-- nn web端访问地址-->
    <property>
        <name>dfs.namenode.http-address</name>

        <value>hadoop102:9870</value>

    </property>

    <!-- 2nn web端访问地址-->
    <property>
        <name>dfs.namenode.secondary.http-address</name>

        <value>hadoop104:9868</value>

    </property>

</configuration>
- yarn-site.xml
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>

<configuration>
    <!-- 指定MR走shuffle -->
    <property>
        <name>yarn.nodemanager.aux-services</name>

        <value>mapreduce_shuffle</value>

    </property>

    <!-- 指定ResourceManager的地址-->
    <property>
        <name>yarn.resourcemanager.hostname</name>

        <value>hadoop103</value>

    </property>

    <!-- 环境变量的继承 -->
    <property>
        <name>yarn.nodemanager.env-whitelist</name>

        <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value>

    </property>

</configuration>
- mapred-site.xml
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>

<configuration>
    <!-- 指定MapReduce程序运行在Yarn上 -->
    <property>
        <name>mapreduce.framework.name</name>

        <value>yarn</value>

    </property>

</configuration>
- 分发配置文件
1、切换用户
su - mhm	# 在mhm用户上执行
cd ~

2、编辑hosts文件
cat > h-all << EOF
[all]
192.168.146.102
192.168.146.103
192.168.146.104
EOF

3、ansible分发文件
ansible -i h-all all -m copy -a "src=/opt/module/hadoop-3.1.3/etc/hadoop/core-site.xml dest=/opt/module/hadoop-3.1.3/etc/hadoop/"
ansible -i h-all all -m copy -a "src=/opt/module/hadoop-3.1.3/etc/hadoop/hdfs-site.xml dest=/opt/module/hadoop-3.1.3/etc/hadoop/"
ansible -i h-all all -m copy -a "src=/opt/module/hadoop-3.1.3/etc/hadoop/yarn-site.xml dest=/opt/module/hadoop-3.1.3/etc/hadoop/"
ansible -i h-all all -m copy -a "src=/opt/module/hadoop-3.1.3/etc/hadoop/mapred-site.xml dest=/opt/module/hadoop-3.1.3/etc/hadoop/"
- 配置DN主机列表
# 全量节点
1、编辑
cat > /opt/module/hadoop-3.1.3/etc/hadoop/workers << EOF
hadoop102
hadoop103
hadoop104
EOF

2、分发
ansible -i h-all all -m copy -a "src=/opt/module/hadoop-3.1.3/etc/hadoop/workers dest=/opt/module/hadoop-3.1.3/etc/hadoop/"
2.4.5 配置历史服务器,开启日志聚集
- 102节点执行
- /opt/module/hadoop-3.1.3/etc/hadoop/mapred-site.xml
<!-- 注意,是把以下内容添加到configuration内,不要全部覆盖啦!!! -->
    <!-- 历史服务器端地址 -->
    <property>
        <name>mapreduce.jobhistory.address</name>

        <value>hadoop102:10020</value>

    </property>

    <!-- 历史服务器web端地址 -->
    <property>
        <name>mapreduce.jobhistory.webapp.address</name>

        <value>hadoop102:19888</value>

    </property>
- 分发
ansible -i /home/mhm/h-all all -m copy -a "src=/opt/module/hadoop-3.1.3/etc/hadoop/mapred-site.xml dest=/opt/module/hadoop-3.1.3/etc/hadoop/"
- 102节点,开启日志聚集
- /opt/module/hadoop-3.1.3/etc/hadoop/yarn-site.xml
<configuration>
    <!-- 指定MR走shuffle -->
    <property>
        <name>yarn.nodemanager.aux-services</name>
        <value>mapreduce_shuffle</value>
    </property>

    <!-- 指定ResourceManager的地址-->
    <property>
        <name>yarn.resourcemanager.hostname</name>
        <value>hadoop103</value>
    </property>

    <!-- 环境变量的继承 -->
    <property>
        <name>yarn.nodemanager.env-whitelist</name>
        <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value>
    </property>
    <!-- 开启日志聚集功能 -->
    <property>
        <name>yarn.log-aggregation-enable</name>
        <value>true</value>
    </property>
    <!-- 设置日志聚集服务器地址 -->
    <property>
        <name>yarn.log.server.url</name>
        <value>http://hadoop102:19888/jobhistory/logs</value>
    </property>
    <!-- 设置日志保留时间为7天 -->
    <property>
        <name>yarn.log-aggregation.retain-seconds</name>
        <value>604800</value>
    </property>
    <property>
        <name>yarn.nodemanager.vmem-check-enabled</name>
        <value>false</value> <!-- 是否启用虚拟内存检查,建议测试集群改为false -->
    </property>
</configuration>
- 同步文件
ansible -i /home/mhm/h-all all -m copy -a "src=/opt/module/hadoop-3.1.3/etc/hadoop/yarn-site.xml dest=/opt/module/hadoop-3.1.3/etc/hadoop/"
2.5 手动开启服务
- 初始化
# 如果集群是第一次启动,,需要在hadoop102节点格式化NameNode
# 注意:
    格式化NameNode,会产生新的集群id,导致NameNode和DataNode的集群id不一致,集群找不到已往数据。如果集群在运行过程中报错,需要重新格式化NameNode的话,一定要先停止namenode和datanode进程,并且要删除所有机器的data和logs目录,然后再进行格式化。

1、格式化
# 登录102节点(因为bin目录已经加入环境变量,所以可以直接使用hdfs命令)
hdfs namenode -format	# 格式化命令

2、查看hadoop家目录,发现会多出data目录,是之前core-site.xml的指定存储数据目录
[mhm@hadoop102 ~]$ ll /opt/module/hadoop-3.1.3/
总用量 176
drwxr-xr-x. 2 mhm mhm    183 9月  12 2019 bin
drwxrwxr-x. 3 mhm mhm     17 5月  30 01:19 data
drwxr-xr-x. 3 mhm mhm     20 9月  12 2019 etc
drwxr-xr-x. 2 mhm mhm    106 9月  12 2019 include
drwxr-xr-x. 3 mhm mhm     20 9月  12 2019 lib
drwxr-xr-x. 4 mhm mhm    288 9月  12 2019 libexec
-rw-rw-r--. 1 mhm mhm 147145 9月   4 2019 LICENSE.txt
drwxrwxr-x. 2 mhm mhm     36 5月  30 01:19 logs
-rw-rw-r--. 1 mhm mhm  21867 9月   4 2019 NOTICE.txt
-rw-rw-r--. 1 mhm mhm   1366 9月   4 2019 README.txt
drwxr-xr-x. 3 mhm mhm   4096 9月  12 2019 sbin
drwxr-xr-x. 4 mhm mhm     31 9月  12 2019 share
- 启动集群服务(手动拉起,了解)
su - mhm	# 全量节点

1、102节点
# 102节点启动NameNode和DataNode
hdfs --daemon start namenode
hdfs --daemon start datanode
jps 	# 查看启动的java进程

2、103节点
# 开启ResourceManager,NodeManager,DataNode
yarn --daemon start resourcemanager
yarn --daemon start nodemanager
hdfs --daemon start datanode
jps
# 返回102节点
yarn --daemon start nodemanager
3、104节点
# 开启Secondary NameNode,NodeManager,DataNode
hdfs --daemon start secondarynamenode
yarn --daemon start nodemanager
hdfs --daemon start datanode
jps


######################################### 关闭 ####################################
1、先关每个节点的从服务
yarn --daemon stop nodemanager
hdfs --daemon stop datanode

2、102节点
hdfs --daemon stop namenode
jps

2、103节点
yarn --daemon stop resourcemanager
jps

3、104节点
hdfs --daemon stop secondarynamenode
jps
- 测试UI界面
# NameNode UI界面	(之前配置的hdfs-default.xml)
hadoop102:9870

# Yarn UI界面
hadoop103:8088

# Secondary NameNode UI界面 (之前配置的hdfs-default.xml)
hadoop104:9868
2.6 脚本群起服务
- 全量查看启动的服务
# 102节点执行
ansible -i /home/mhm/h-all all -m shell -a "/opt/module/jdk1.8.0_212/bin/jps"

# 102节点设置别名
vim ~/bashrc
alias myjps='ansible -i /home/mhm/h-all all -m shell -a "/opt/module/jdk1.8.0_212/bin/jps"'

# 执行命令
[mhm@hadoop102 ~]$ myjps
192.168.146.104 | CHANGED | rc=0 >>
1746 NodeManager
1655 SecondaryNameNode
2120 Jps
1564 DataNode
192.168.146.103 | CHANGED | rc=0 >>
2457 Jps
2043 NodeManager
1565 DataNode
1727 ResourceManager
192.168.146.102 | CHANGED | rc=0 >>
1688 NameNode
2120 NodeManager
2248 JobHistoryServer
1850 DataNode
2795 Jps
- 繁琐步骤
# 因为已经配过/opt/module/hadoop-3.1.3/sbin的环境变量,所以该目录下的脚本可以直接使用
# 注意:群起脚本需要全部节点都事先配置/opt/module/hadoop-3.1.3/etc/hadoop/workers

1、102节点
start-dfs.sh

2、103节点
start-yarn.sh

3、全量节点
jps

################################ 停止全部服务	################################
1、102节点
stop-dfs.sh

2、103节点
stop-yarn.sh

3、全量节点
jps
- 脚本实现
vim /home/mhm/bin/myhadoop.sh

#!/bin/bash

if [ $# -lt 1 ]
then
    echo "No Args Input..."
    exit ;
fi

case $1 in
"start")
        echo " =================== 启动 hadoop集群 ==================="

        echo " --------------- 启动 hdfs ---------------"
        ssh hadoop102 "/opt/module/hadoop-3.1.3/sbin/start-dfs.sh"
        echo " --------------- 启动 yarn ---------------"
        ssh hadoop103 "/opt/module/hadoop-3.1.3/sbin/start-yarn.sh"
        echo " --------------- 启动 historyserver ---------------"
        ssh hadoop102 "/opt/module/hadoop-3.1.3/bin/mapred --daemon start historyserver"
;;
"stop")
        echo " =================== 关闭 hadoop集群 ==================="

        echo " --------------- 关闭 historyserver ---------------"
        ssh hadoop102 "/opt/module/hadoop-3.1.3/bin/mapred --daemon stop historyserver"
        echo " --------------- 关闭 yarn ---------------"
        ssh hadoop103 "/opt/module/hadoop-3.1.3/sbin/stop-yarn.sh"
        echo " --------------- 关闭 hdfs ---------------"
        ssh hadoop102 "/opt/module/hadoop-3.1.3/sbin/stop-dfs.sh"
;;
*)
    echo "Input Args Error..."
;;
esac
2.7 集群测试

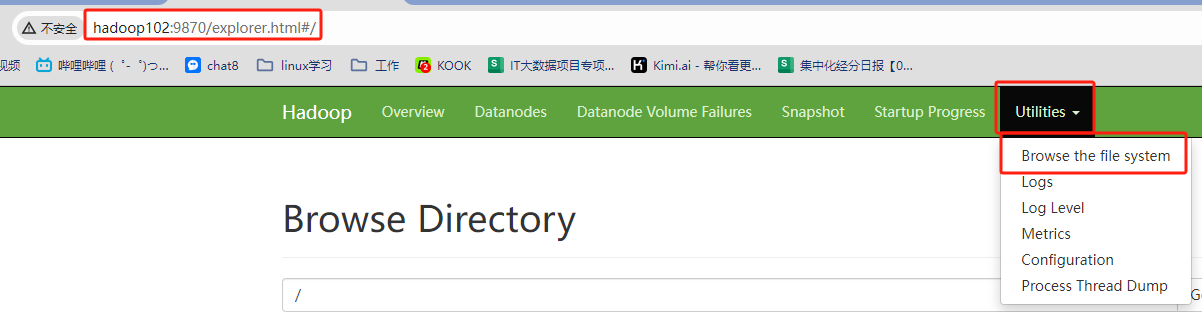

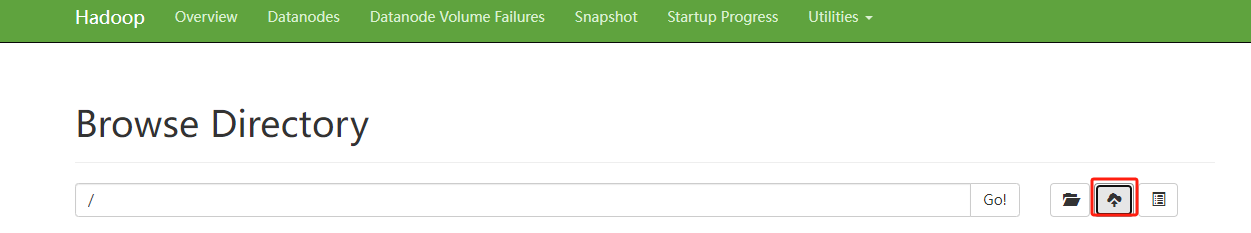

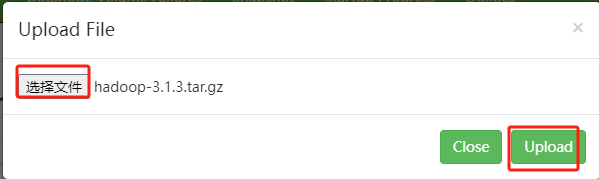

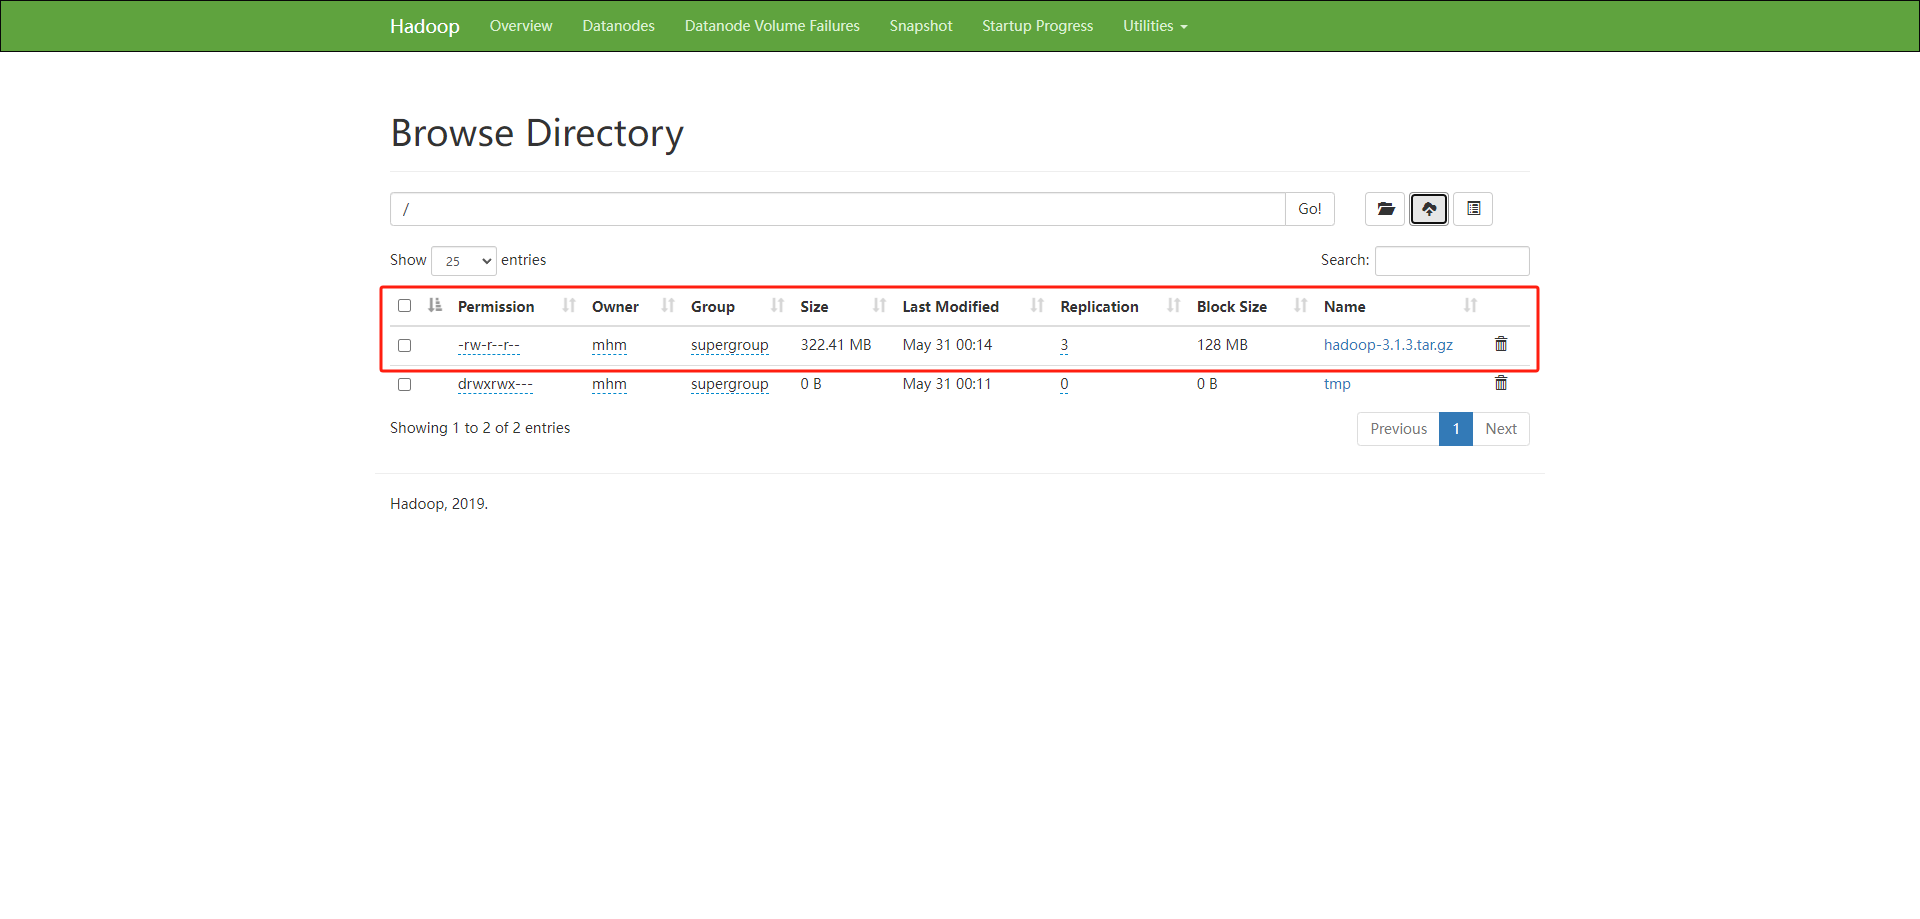

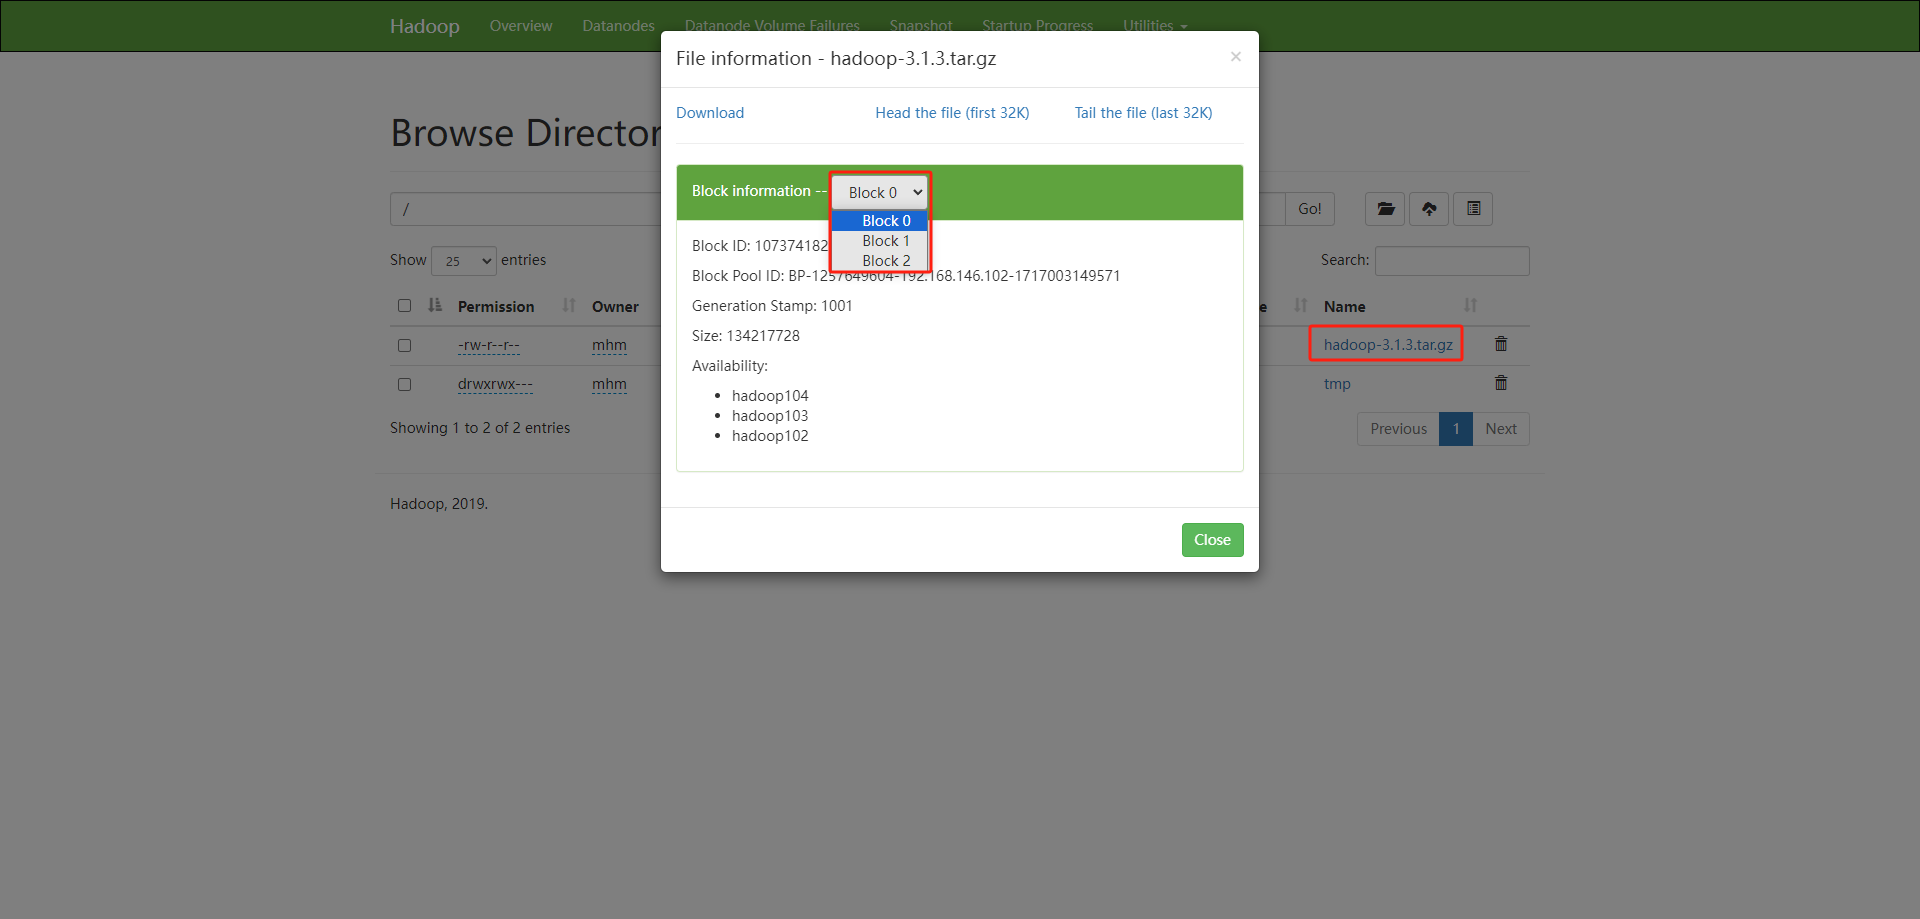
通过测试上传文件,发现本来实际hadoop的这个包是322MB,但是他分成3个数据块,前面2块128MB后面一块66多MB。
并且在最后一张图上可以查看到
Availability:
hadoop102
hadoop104
hadoop103

表示该数据块的副本存储在 hadoop102、hadoop103 和 hadoop104 这三个节点上
- 再次执行命令测试
# 在任意节点执行均可
1、 新建一个测试文件
cat > /tmp/hello.txt << EOF
hadoop yarn byd
hadoop mapreduce ok
mhm byd ko
mhm byd
EOF

2、创建hdfs文件夹
hdfs dfs -mkdir /test

3、上传文件至该文件夹内
hdfs dfs -put /tmp/hello.txt /test/

4、执行测试命令
hadoop jar $HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.1.3.jar wordcount /test /test2

5、查看执行结果
[mhm@hadoop104 ~]$ hdfs dfs -ls /test2/
Found 2 items
-rw-r--r--   3 mhm supergroup          0 2024-05-31 00:54 /test2/_SUCCESS
-rw-r--r--   3 mhm supergroup         50 2024-05-31 00:54 /test2/part-r-00000
[mhm@hadoop104 ~]$ hdfs dfs -cat /test2/part-r-00000
2024-05-31 00:55:40,562 INFO sasl.SaslDataTransferClient: SASL encryption trust check: localHostTrusted = false, remoteHostTrusted = false
byd	3
hadoop	2
ko	1
mapreduce	1
mhm	2
ok	1
yarn	1

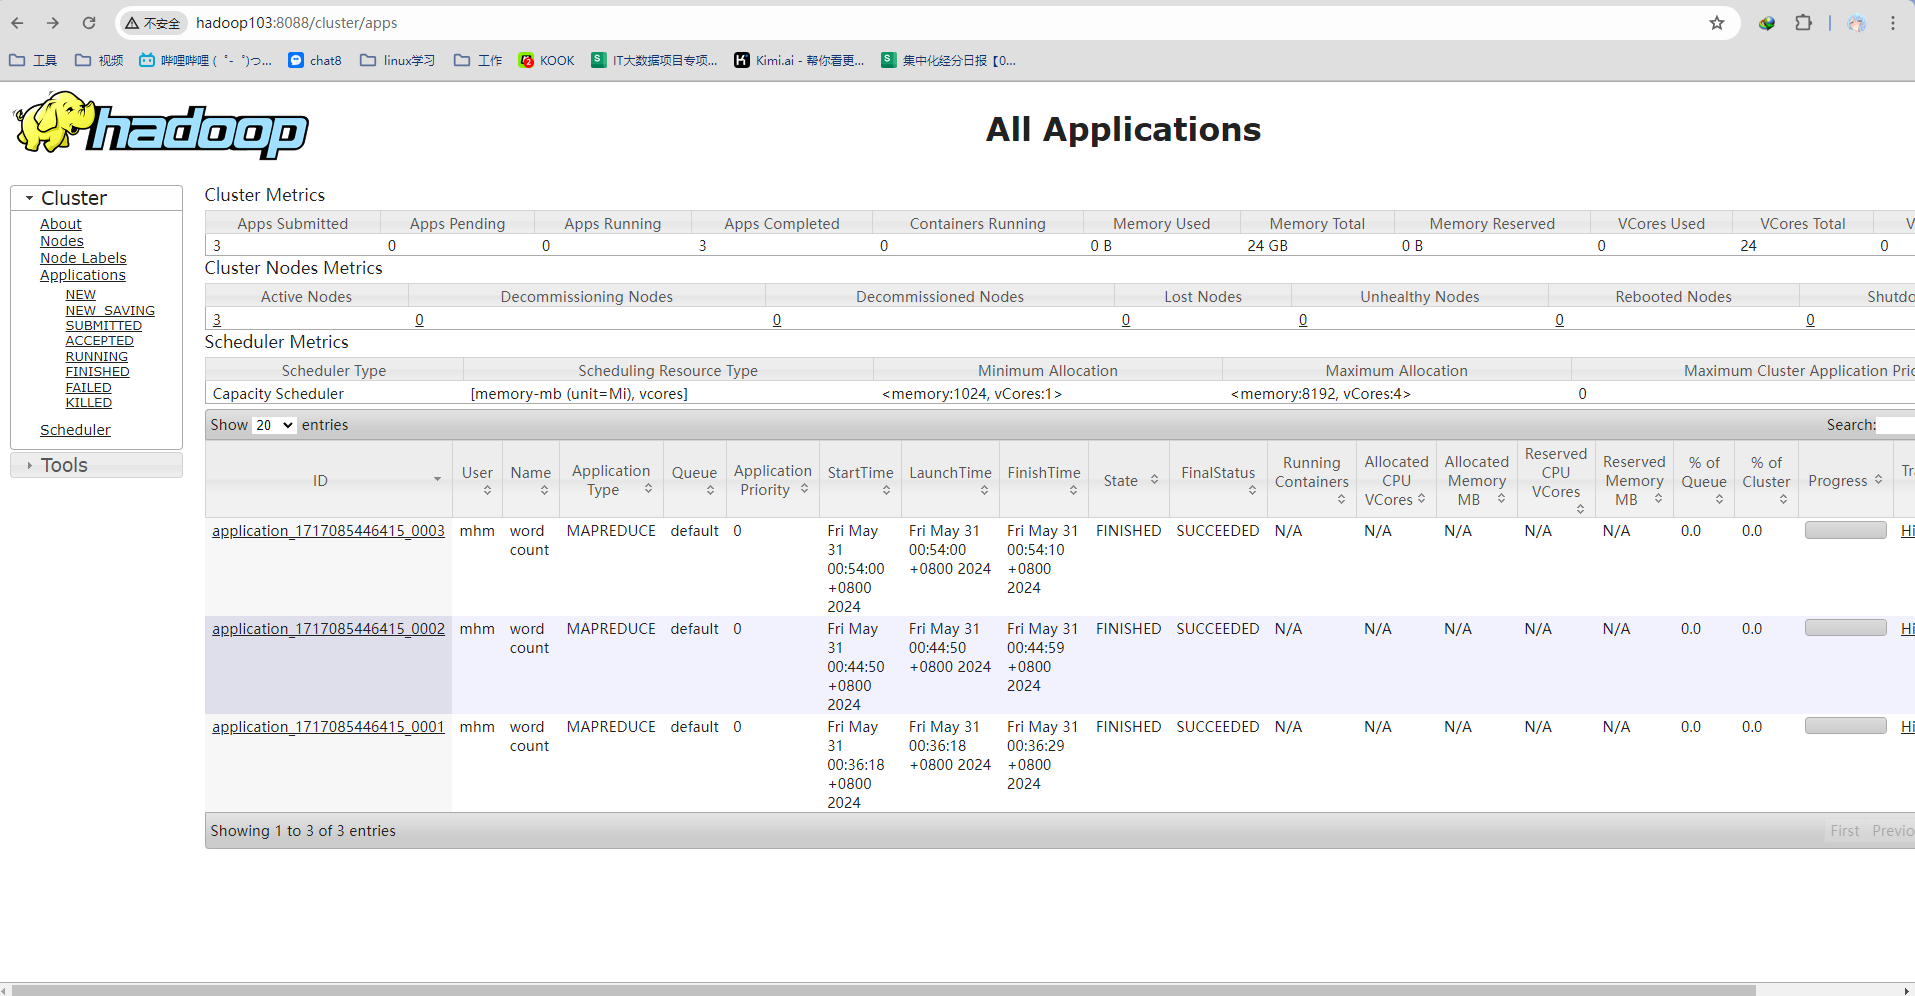
6、查看刚刚执行的mr任务,如下图

2.8 集群URL
| YARN UI | http://hadoop103:8088/cluster |
|---|---|
| NameNode HTTP UI | http://hadoop102:9870/ |
| History UI | http://hadoop102:19888/jobhistory |
| SecondaryNameNode | |
2.9测试mr命令
/opt/module/hadoop-3.1.3/bin/hadoop jar /opt/module/hadoop-3.1.3/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.1.3.jar pi 16 1000